零到全栈 · 课程
模块 7.4:看懂流量——访客日志与埋点
网站上线了,有人来过吗?这一节从 Nginx 的访客日志出发看懂流量,再顺着看到的问题做三件事:把坏的挡在门外,让好的来得更快,弄清到底来了多少人。
有人来过吗
有了域名和 HTTPS,网站已经可以推广了,下一个问题是:
有人来过吗? 来过几个?看了哪一页?来的是人还是机器人?
我们首先可以在 Nginx 的访客日志里获得答案。
一般情况下,配置了域名和 HTTPS 的网站只要上线,就会有“流量”。上一节录制视频时用的演示站 https://playharder.online(我自己部署的 zero-to-tech 网站),在配好域名和证书之后的第二天里,就来了 2376 个请求。但是那个时候我的视频还在剪辑,没有发布到哔哩哔哩,所以理应没人知道我这个域名。
一个没人知道的新网站,怎么会这么快就有"人"找上门?
这是因为我们找 CA 申请的每一张公开签发的证书,都会被登记进一份全世界都能查的公开名单,新域名一上名单,也就等于告诉了全网"这里有个新网站"。不少扫描器就盯着这份名单,再加上还有一些程序整天把全网的 IP 挨个扫一遍,所以一个网站即使刚上线也会有访客——只是大多不是人。
接下来我们就仔细看一看这个 Nginx 访客日志。
读懂访客日志
下面这些全部摘自李勃老师自己部署的 zero-to-tech 网站(后面我称它为“演示站”)的访客日志,这是它 2026 年 10 月 23 日傍晚的一段访客日志,只把 IP 打了码:
154.222.xx.xx - - [23/Oct/2026:17:40:11 +0800] "GET /apps/vendor/phpunit/phpunit/src/Util/PHP/eval-stdin.php HTTP/1.1" 404 162 "-" "libredtail-http"
154.222.xx.xx - - [23/Oct/2026:17:40:20 +0800] "GET /containers/json HTTP/1.1" 404 162 "-" "libredtail-http"
91.107.xx.xx - - [23/Oct/2026:17:55:28 +0800] "GET / HTTP/1.1" 200 2505 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36"
91.107.xx.xx - - [23/Oct/2026:17:55:28 +0800] "GET /robots.txt HTTP/1.1" 404 134 "-" "Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:131.0) Gecko/20100101 Firefox/131.0"
91.107.xx.xx - - [23/Oct/2026:17:55:29 +0800] "GET /sitemap.xml HTTP/1.1" 404 134 "-" "Mozilla/5.0 (iPad; CPU OS 18_1 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/18.1 Mobile/15E148 Safari/604.1"
183.240.xx.xx - - [23/Oct/2026:18:02:43 +0800] "GET / HTTP/1.1" 200 2505 "-" "Mozilla/5.0"
5.133.xx.xx - - [23/Oct/2026:18:33:52 +0800] "GET / HTTP/1.1" 200 2505 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/105.0.0.0 Safari/537.36"
5.133.xx.xx - - [23/Oct/2026:18:33:54 +0800] "GET /favicon.ico HTTP/1.1" 404 196 "-" "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/105.0.0.0 Safari/537.36"
一眼看上去密密麻麻,但是不要怕,其实它们有章可循。
一行日志的八个字段
一份日志会有很多条记录,每一条记录又因为长度太长而换行,我们阅读起来就会吃力。
但其实每一行日志的结构还是很清晰的,这里用一条记录来举例子:
14.117.xx.xx - - [24/Oct/2026:11:45:33 +0800] "POST /api/analyze HTTP/1.1" 200 156 "https://www.example.com/text-lab" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ... Chrome/155.0.0.0 Safari/537.36"
一行记录有 8 个字段,字段之间用空格隔开(本身带空格的字段,用方括号或双引号括起来),拆开看,发现几乎全是老朋友:
| 日志里的段 | 它是什么 | 在哪见过 |
|---|---|---|
14.117.xx.xx | 访客的 IP | 访客 IP 地址,我们在 5.3 手搓 API 时看到过 client_address |
- - | 两个身份字段:第一个是早年的遗留,Nginx 直接写死成 -;第二个是 HTTP 认证的用户名,很少用 | 没见过,认脸即可,跳过 |
[24/Oct/2026:11:45:33 +0800] | 请求发生的时间,+0800 是东八区,也就是北京时间 | —— |
"POST /api/analyze HTTP/1.1" | 请求行:方法+路径+协议版本 | 5.3 讲的 HTTP 请求的第一行 |
200 | 状态码:成功 | 2xx / 3xx / 4xx / 5xx 状态码家族 |
156 | 响应正文的字节数,这里表示有 156 个字节 | HTTP 响应头里那个 Content-Length 的近亲 |
"https://www.example.com/text-lab" | Referer:这个请求是从哪个页面发出来的。如果是 - 就表示没有来源 | 一个浏览器自动带上的请求头 |
"Mozilla/5.0 (Macintosh; ...)" | User-Agent,简称 UA | 5.3 里对比过 curl 和浏览器各自的 UA |
这就是一行访客日志所记录的详细内容,它忠实地记录了一个 HTTP 请求的基本信息。
除了两个身份字段之外(两个身份字段其实很少用,所以一般都是 - -),其他的内容我们都不陌生,但是关于开头的 IP 和末尾的 UA,我们值得再详细讲一下。
IP:访客的地址
IP 是直接连上来的那台机器(或者说网络设备)的地址。IP 没法随便填。因为服务器的回复要寄回这个地址,如果填个假的,就收不到回复了。所以日志里的 IP,是"真的有一台机器从这个地址连了上来"。
但它也只说明这么多:
- 它说的是机器,不是人。 一家人共用一个 Wi-Fi,出口是同一个 IP;同一个人出门换了 5G,IP 就变了。所以不能单纯地用 IP 来标记一个用户。
- 它说的是"直接来敲门的那一台"。 中间要是隔着代理、VPN,日志里记下的就是代理的地址。
- 它能查出个大概的地方。 IP 是按地区分配的,查一下就知道大致来自哪个国家、哪个城市。也正因为这样,IP 算个人信息——这份课件里的 IP 都打了码。
UA:一句自我介绍
UA 是请求方附上的一段"自我介绍":什么系统、什么浏览器、什么版本。看一看刚才那一行记录的 UA:
Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/155.0.0.0 Safari/537.36
这是一台 Mac 电脑通过 Chrome 浏览器访问之后留下的 UA 信息,里面有两处说明了这个信息
- 括号里的
Macintosh; Intel Mac OS X 10_15_7说明这是一台 Mac - 后面的
Chrome/155.0.0.0说明这是 Chrome 浏览器,并且是 155 版
但是这里并不是语义层面上的精准信息,比如说最近几年推出的 Mac 都已经不再用 Intel 的芯片了,但其 UA 信息也会写 Intel Mac。
开头的 Mozilla/5.0、中间的 AppleWebKit、末尾的 Safari,都是历史包袱——早年间各家浏览器为了不被网站拒之门外,纷纷在自我介绍里捎上别家的名字,一路沿袭下来。所以从 UA 中分析真正的操作系统和浏览器,就很依赖经验。但反过来看,基于经验我们还是能大致看出访客用的是手机还是电脑、什么浏览器。
还要注意,UA 和 IP 不一样,它是请求方自己填的,想填什么就填什么。 所以可以填假信息,也可以填一些很个性化的东西。比如说我在演示站的日志中就发现了三种值得注意的情况:
- 同一个 IP,一秒之内换了 3 个 UA 来请求(先说自己是 Mac 上的 Chrome,再说是 Ubuntu 上的 Firefox,接着又成了一台 iPad)
91.107.xx.xx - - [23/Oct/2026:17:55:28 +0800] "GET / HTTP/1.1" 200 2505 "-" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/131.0.0.0 Safari/537.36"

91.107.xx.xx - - [23/Oct/2026:17:55:28 +0800] "GET /robots.txt HTTP/1.1" 404 134 "-" "Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:131.0) Gecko/20100101 Firefox/131.0"

91.107.xx.xx - - [23/Oct/2026:17:55:29 +0800] "GET /sitemap.xml HTTP/1.1" 404 134 "-" "Mozilla/5.0 (iPad; CPU OS 18_1 like Mac OS X) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/18.1 Mobile/15E148 Safari/604.1"
- 一个看上去有点离谱的浏览器 UA(只写一个光秃秃的
Mozilla/5.0。真浏览器不会这么写,这是程序随手填的)
183.240.xx.xx - - [23/Oct/2026:18:02:43 +0800] "GET / HTTP/1.1" 200 2505 "-" "Mozilla/5.0"
- 一个声明了自己并非浏览器的 UA
154.222.xx.xx - - [23/Oct/2026:17:40:20 +0800] "GET /containers/json HTTP/1.1" 404 162 "-" "libredtail-http"
后面我们还会看到一类访客,在 UA 里大大方方写明"我是爬虫"。
顺带一提:请求方自己填的,不只是 UA,Referer 也一样。演示站的日志里就有这么一行:
201.176.xx.xx - - [24/Oct/2026:21:01:08 +0800] "GET / HTTP/1.1" 200 2505 "https://acquire.co.in/redirect.php?ref_host=ambulanter-zahnarzt.care" "Mozilla/5.0 (X11; Linux x86_64; rv:127.0) Gecko/20100101 Firefox/127.0"
Referer 说它是从一个印度网站跳过来的,可我们的网站从没在那里出现过。这叫来源垃圾(Referer spam):程序故意在 Referer 里填上别人的网址,赌的是站长翻日志、看来源时好奇点进去。所以 Referer 和 UA 一样,只能当作参考,不能当真。
自己动手看日志
接下来,你可以看一看自己的 Nginx 访客日志了。我们上一节在网站的 server 块里加了一行 access_log /var/log/nginx/example.com.access.log; 从那以后,通过域名进了网站的请求就单独记在了 example.com.access.log 这个文件里(把 example.com 换成你真实的域名);
注意,现在你的 sites-enabled 里已经至少有两个生效的 Nginx 配置文件了,并且有多个 server 块,只有一个 server 块的日志记在
example.com.access.log这个文件里,其它的还是记在 access.log 文件中。
接下来就可以到服务器上看一眼这个目录(只列出相关的几个):
ls /var/log/nginx/
可以看到这个目录中列出来的有这样的文件:
access.log                    ← 默认的那份:兜底块、80 小块的请求
access.log.1
access.log.2.gz
error.log                     ← 错误日志
example.com.access.log        ← 我们网站自己的访客日志
example.com.access.log.1
example.com.access.log.2.gz
Ubuntu 默认每天把每份日志切一次,今天的在 example.com.access.log,昨天的变成 example.com.access.log.1,更早的压缩成 .2.gz、.3.gz……一般保留两周左右。
所以访客日志其实是一摞文件,今天那个只是最上面一页。想把这一摞连同压缩过的一起读出来,可以用 zcat -f:
sudo zcat -f /var/log/nginx/example.com.access.log* # * 匹配所有翻过去的页;zcat -f 会顺手把压缩过的解开
后面统计流量时,用的都是这一整摞。
此外,如果是有报错,会记录在 error.log
如果只是看当天的,我们可以通过 cat 来查看 example.com.access.log 日志,不过一般我们只看最近几条就够了,如果想要看日志的最后几行,可以用 tail 命令:
sudo tail /var/log/nginx/example.com.access.log # tail:看文件的最后几行,默认 10 行
(日志文件只给管理员读,所以前面要加 sudo)
也可以在 tail 后面加一个 -f(follow):它会守着文件,新内容一来就滚出来:
sudo tail -f /var/log/nginx/example.com.access.log # Ctrl+C 退出
这种 tail -f 的写法很实用,开着它的同时如果访问网站,日志就会实时滚出来。如果在文字实验室点一下"开始分析",也会冒出一行 POST /api/analyze,这就是排查线上问题的第一现场。
遇到有人说网站"打不开",我们排查问题的时候就可以开着
tail -f让他再试一次,看请求到底有没有到、状态码是什么。
从日志里看流量
能够读懂访客日志,就可以从中挖掘一些网站的流量信息了:哪些页面被打开得最多?来了多少人?有没有机器人?有没有人在使坏?
如何分析访客日志
在今天,分析访客日志已经越来越轻松,比如说:
- 我们可以直接把日志 download 到本地,交给 AI 帮我们分析
- 我们也可以让 AI 按我们的分析需求帮我们写一些 Linux 命令,我们在服务器上执行
- 我们甚至可以直接把服务器交给 AI,让 AI 帮我们全程搞定分析的事情
这里我介绍第二种方式,就是执行一些 Linux 命令,直接分析访客日志。
这些命令不用记。 我们要清楚的只有两样:一是日志在哪、长什么样,前面已经认识了;二是自己想问什么。至于命令本身,就交给 AI 去写。
问 AI 之前,先把背景交代清楚。下面这段话可以当作 prompt 固定的开头,每次都带上(注意把其中 example.com 换成你自己的真实域名):
我有一台 Ubuntu 服务器,Nginx 的访客日志在`/var/log/nginx/example.com.access.log`,日志每天会翻页,旧的在 .1 和 .gz 里,统计时请把它们一起算上。请给我一条能直接在终端运行的命令(读日志需要 sudo)
然后接上这一次真正想问的那一句。
此前的课件中,每次 Linux 命令我都会写出来让你复制,并且希望你能理解那条命令。但是当前这一节我会优先给你 prompt,你理解 prompt 即可。同时我也会提供 Linux 命令,当 AI 给你的命令跑不通或者结果看着不对劲,再复制我提供的 Linux 命令。
哪些路径被请求得最多
先看看最近这段时间,每个路径被请求了多少次,prompt 如下:
统计每个路径被请求了多少次,从多到少列出前 20 个。
命令(记得把 example.com 换成你的真实域名):
sudo sh -c 'zcat -f /var/log/nginx/example.com.access.log* | awk "{print \$7}" | sort | uniq -c | sort -rn | head -20'
演示站的统计结果(以下数字都来自演示站,每个人的服务器各不相同):
    619 /
     70 /_next/static/chunks/255-eb4aecc3ff015961.js
     69 /_next/static/chunks/4bd1b696-c023c6e3521b1417.js
     68 /_next/static/chunks/webpack-abe73da5cd9824dc.js
     68 /_next/static/chunks/416-6a66c8052feb5d6f.js
     67 /_next/static/chunks/app/page-792bdc6c6cced4a7.js
     61 /favicon.ico
     59 /_next/static/chunks/main-app-0a832c3186bfaaef.js
     ...
     47 /robots.txt
     36 /.env
     34 /.git/config
排第一的是首页 /,619 次。可紧跟在后面的那几个 JS 文件,都只有 70 次上下。
这就不对劲了。浏览器打开首页,一定会请求一遍页面要用的 JS,所以对首页的请求数和对 JS 的请求数应该不会有这么大的差距,那为什么看到的数字差了这么多呢?
理论上是有两个原因:
- 有一些用户的浏览器可能会带有缓存,当再次访问的时候就没有再请求 JS
- 请求并非来自浏览器,而是来自一些只拿 HTML 不跑 JS 的程序,比如扫描器、爬虫和各种探测工具
实际上,更大的原因是第二个——那 600 多次请求里面,大部分都不是真实的用户,而是一些自动化程序。
一行日志是一次请求,不是一次浏览。一个人通过浏览器打开网站首页时,会向 Nginx 发送好几条请求:HTML 一行,那几个 JS 各一行,CSS 一行,还有浏览器自动去要的 /favicon.ico 等。
很多人会把访客日志中的请求数和 PV 联系起来,但统计里常说的 PV(Page View,页面浏览量),指的是页面被人看了多少次——机器的请求不算。而日志里能数的,只是"页面被请求了多少次",其实很难真正准确地计算出 PV,即"页面被人看了多少次"。
来了多少个 IP
除了页面被人看了多少次之外,还有一个指标是关于网站来了多少人。统计里管这个叫 UV(Unique Visitor,独立访客),数的是人。
日志里能直接数的,只有 IP,那就先数一数,有多少个不同的 IP,prompt 如下:
数一数一共有多少个不同的访客 IP。
命令(记得把 example.com 换成你的真实域名):
sudo zcat -f /var/log/nginx/example.com.access.log* | awk '{print $1}' | sort -u | wc -l
演示站查出来的是 502 个。
但 IP 不等于人:
- 一家人连着同一个 Wi-Fi,出口是同一个 IP,算出来只有"一个人";
- 同一个人,在家用 Wi-Fi、出门换 5G,IP 变了,算出来成了"两个人"。
稍微聪明一点的办法是把 IP 和 UA 拼在一起再去重(同一个 Wi-Fi 下,爸爸的 iPhone 和妈妈的安卓机,UA 不一样,就能分开算了),prompt 如下:
把"IP 加上 User-Agent"当成一个访客,数一数一共有多少个不同的访客。
命令(记得把 example.com 换成你的真实域名):
sudo zcat -f /var/log/nginx/example.com.access.log* | awk -F'"' '{split($1, a, " "); print a[1], $6}' | sort -u | wc -l
演示站统计出来的数字是 723 个——更"聪明"的算法,算出来的人反而更多了。
想想开头那段日志里一秒换三副面孔的那个 91.107.xx.xx:在这个算法眼里,它就是三个人。对真人,“IP + UA"确实更准一些;可机器越会伪装,这个数就越虚。
一个没对外公布过的演示站,三天"来了"五六百人,这显然不是真的。所以光靠访客日志,算不清来了多少人。
机器人:搜索引擎和 AI 的爬虫
目前看下来,似乎对我们干扰最大的就是这些机器人访客了,那么我们可以单独统计一下这些请求,prompt 如下:
找出 User-Agent 里带 bot、spider 或 crawl 的请求,按 User-Agent 统计次数,从多到少列出前 10 个。
命令(记得把 example.com 换成你的真实域名):
sudo zcat -f /var/log/nginx/example.com.access.log* | awk -F'"' 'tolower($6) ~ /bot|spider|crawl/ {print $6}' | sort | uniq -c | sort -rn | head
演示站的结果(UA 有删减):
    180 Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
     29 Mozilla/5.0 (compatible; Qwenbot/1.0; +https://qwen.alibaba.com/)
     28 Mozilla/5.0 (compatible; Kimi-SearchBot/1.0; +https://kimi.ai/)
     28 Mozilla/5.0 ... (compatible; bingbot/2.0; +http://www.bing.com/bingbot.htm) ...
     26 Mozilla/5.0 ... (compatible; Claude-User/1.0; +claudebot@anthropic.com)
     25 Mozilla/5.0 ... (compatible; ClaudeBot/1.0; +claudebot@anthropic.com)
     24 Mozilla/5.0 (compatible; ChatGLM-Spider/1.0; +https://zhipuai.cn/)
     22 Mozilla/5.0 (compatible; Bytespider; spider-feedback@bytedance.com) ...
     22 Mozilla/5.0 (compatible; Baiduspider/2.0; +http://www.baidu.com/search/spider.html)
     22 Mozilla/5.0 ... (compatible; GPTBot/1.4; +https://openai.com/gptbot)
     21 Mozilla/5.0 ... (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)
这些都是爬虫:各家公司派出来的程序,在全网挨个网站地翻页面。它们是好客人,还挺守规矩——因为它们会在 UA 里自报家门,留了一个说明网址。
Googlebot、bingbot、Baiduspider 都很容易认出来是搜索引擎的爬虫,这些爬虫会把网页采集回去建索引,便于以后用户可以搜到我们的网站。
剩下的名字,大多来自 AI 公司:OpenAI(GPTBot)、Anthropic(ClaudeBot、Claude-User)、阿里通义(Qwenbot)、月之暗面(Kimi-SearchBot)、智谱(ChatGLM-Spider)、字节跳动(Bytespider)……上线才三天,从名字上看,AI 公司的已经比搜索引擎的还多。
它们来的目的不止一种:
| 用途 | 例子 | 来干什么 |
|---|---|---|
| 收集训练数据 | GPTBot、ClaudeBot | 把网页存回去,给大模型当"课本” |
| 给 AI 搜索建索引 | PerplexityBot、Kimi-SearchBot | 和搜索引擎一个路数,只是搜的换成了 AI |
| 替用户临时来取 | Claude-User | 有人在 AI 里问到了这个网站,AI 当场来读一下 |
对于这些“守规矩”的爬虫,我们其实可以对它们的行为进行“表态”,比如欢迎 AI 来搜、谢绝拿去训练等。
在哪儿表态?规矩的爬虫进门前,会先去读网站根目录下一个叫 robots.txt 的文件,看主人允许它爬哪些地方。
我们仍需清醒地记得:UA 可以自己填。自称 Googlebot 的,不一定真是 Google。
顺手创建一个 robots.txt
刚才看请求最多的前 10 个路径的时候,可以看到 /robots.txt 被要了 47 次。但是我们项目中目前还没有这个文件,所以这 47 次请求每次都只能拿到 404。
既然它们这么高频地来问,那我们就给一个答复。
在项目根目录下新建一个 public 文件夹,里面放一个 robots.txt。这是 Next 的约定:public/ 里的文件,build 时原样拷进 out/,访问路径就是文件名——https://example.com/robots.txt。
User-agent: *
Disallow: /api/

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
读法很简单:每一组是"对谁(User-agent)+哪儿不许去(Disallow)"。爬虫会找写给自己的那一组照办。比如说有一组是写给 GPTBot 的,那么 GPTBot 看到这一组,就会发现整站都不允许它爬;Googlebot 没有专门写给它的,就照 * 那组来办,也就是除了 /api/,都可以爬。
拦谁、放谁,是一个选择,不是标准答案。 拦了训练用的爬虫,AI 就学不到我们的内容;放开,我们的内容可能出现在 AI 的回答里。这里只是演示写法。还要留意:ClaudeBot 和 Claude-User 是两个名字——拦了训练用的那个,不影响有人让 Claude 临时来读一下。
添加了 robots.txt 之后,需要再走一次上线发布流程:
# 本地提交并push
git add -A && git commit -m "添加 robots.txt" && git push
# 服务器更新代码重新构建
cd ~/zero-to-tech && git pull && npm run build
浏览器打开 https://example.com/robots.txt,能看到这份告示,就说明搞定了。以后这些爬虫就能拿到这份告示了。
robots.txt是告示,不是门锁,只有守规矩的才看——防君子不防小人。
不怀好意的嗅探
除了守规矩的机器人,其实还有一类是不守规矩的机器人。这些不守规矩的机器人中,有一些可以通过 UA 识别出来,但是有一些却有意在伪装成正常访客的 UA。
我们可以从那些 404 请求里面找到一些蛛丝马迹,prompt 如下:
把 /var/log/nginx/ 底下所有名字里带 access.log 的访客日志(包括翻页的旧日志)放在一起,找出状态码是 404 的请求,按路径统计次数,从多到少列出前 10 个。
命令:
sudo zcat -f /var/log/nginx/*access.log* | grep '" 404 ' | awk '{print $7}' | sort | uniq -c | sort -rn | head
演示站那台服务器的结果(那台机器上还部署了课件网站 李勃老师.com,几份日志一起算了进来,所以数字更大):
    346 /
    298 /favicon.ico
    124 /robots.txt
    121 /SDK/webLanguage
     72 /account
     69 /_next/static/chunks/react-flight
     68 /login
     63 /_next/turbopack/flight
     61 /.git/config
     61 /.env
     47 /.env.local
     40 /.env.save
     37 /.env.production
    ...
排在最前面的三个不算坏:/ 大多是拿 IP 来访问、落进兜底块的,另外两个也正常。而往下看,就出现了一些奇怪的路径。概括下来大致是这些:
| 它来要的 | 它想找什么 |
|---|---|
/.env、/.env.local、/.env.save、/.env.bak、/.env.old…… | 配置文件里的密码和密钥(7.1 讲过 .env 里放的是什么)——连"备份时可能起什么名字"都替我们猜好了 |
/.git/config | 整个代码仓库 |
/login、/account、/sign-in | 登录页,找到了就准备试密码 |
…/phpunit/…/eval-stdin.php、/index.php?s=…invokefunction… | 几个 PHP 框架的老漏洞,补丁出来很多年了,总有人没打 |
/containers/json | 没设防的 Docker——找到了能直接接管整台机器 |
/v1/models | 没设防的大模型接口——有人自己部署了模型、忘了设密码,算力就成了别人的 |
/SDK/webLanguage | 某品牌网络摄像头的漏洞 |
/_next/…/react-flight、/_next/turbopack/flight…… | Next.js 服务端功能的漏洞——2025 年底 React / Next.js 曝出过一个满分的高危漏洞 |
演示站的日志里还有一位自报家门的:UA 写着 libredtail-http,一分钟之内,把 PHP 的几个老漏洞和 Docker 挨个试了一遍。这是一个专门入侵服务器、装挖矿程序的僵尸网络。它甚至都懒得在 UA 里伪装自己,非常嚣张——它赌的就是网站有漏洞并且完全不做安全维护。
通过这张表,我们可以发现两个事实:
- 它们根本不在乎我们是谁。 摄像头的、PHP 的、Docker 的、大模型的,见门就敲,敲错了也不损失什么。
- 它们跟着时代走。
/v1/models、Next.js 那几条,都是这一两年才冒出来的新目标。
这些不怀好意的嗅探,会侵害到我们吗?如果你现在的网站是跟随我们这个课程一模一样做出来的,那么目前来看不会被侵害(除非某一天我们依赖的底层组件突然被爆出来一个什么意想不到的严重漏洞)。
所以看到它们别慌。这是公网的常态,并非针对我们——每台公网服务器每天都在被这样扫。上面这些,全都吃了 404,什么也没拿到。
很惊险,但这就是互联网。
热闹会退潮
看到这里,可能会担心:这么多机器人,难道会一直这样扫下去?
不会。把演示站每天的请求数排出来(prompt:“按日期统计每天有多少个请求”):
| 日期 | 请求数 | |
|---|---|---|
| 10 月 20 日 | 151 | 晚上 11 点多才配好域名和证书,只记了不到一个小时 |
| 10 月 21 日 | 2376 | |
| 10 月 22 日 | 2802 | 最高峰 |
| 10 月 23 日 | 1632 | |
| 10 月 24 日 | 约 1200 |
头两天最热闹,之后就回落了。根据我在演示站的统计,有一些机器人过来扫描一圈,后面就不会再来了,但是有一些还会持续过来:
- 很多扫描器,扫完一圈就走。 冒充 Mac 上 Chrome 的那个访客,疯狂请求了 1193 次;专门试探 Next.js 的
WebSiphon也请求了 669 次。它们是看到新域名上了名单,蜂拥而至,扫完一遍,就去找下一个新网站了。 - 还在来的,有两类。 一类是搜索引擎和 AI 公司的爬虫,比如 Googlebot,隔一阵就回来看看有没有新内容,AI 爬虫要收敛一些,GPTBot 请求了 22 次,ClaudeBot 请求了 25 次;另一类是不断冒出来的新扫描器,今天这个,明天那个。
所以,新网站上线头几天会有一波"开张潮",之后回落到日常的底噪。不过底噪也不低:一个没人知道的网站,每天照样有上千个请求,大部分还是机器。
优化思路
看了一圈访客日志,你应该已经想要做点什么了:
- 防护:对于扫描器,尤其是恶意的嗅探,能不能挡在门外?
- 优化:真正的访客打开一个页面,要下载一大串文件,能不能让它们来得更快?
- 统计:既然通过请求和 IP 无法精准描绘流量,那对于用户行为的统计,比如说到底来了多少人、用什么设备、看了什么,能不能有个更靠谱的答案?
下面一个一个来。
防护
Nginx:拒绝明显不怀好意的请求
刚才那些扫描路径有个共同点:我们的网站上根本没有这些东西。我们没有 PHP,没有 WordPress,也绝不会把 .env、.git 放在网站目录里。所以,凡是来要这些的,都可以判定为不怀好意,可以用 return 444 直接挂断。444 是 Nginx 特有的"状态码":它不会发给对方,只是 Nginx 记在自己日志里的一个标记,意思是"这条我没回复,直接把连接挂断了"。
打开我们网站的配置(上一节拆出来的那份):
sudo vim /etc/nginx/sites-available/example.com
在 443 的那个 server 块里加上一些防护配置,你可以让 AI 帮你写,prompt 如下:
我的网站跑在 Ubuntu 上的 Nginx 里:前端是静态文件,接口通过 location /api/ 反向代理给本机 8000 端口的后端。网站上没有任何 PHP 之类的后端脚本,也没有以点开头的隐藏文件。

访客日志里每天都有扫描器在试探,我想让 Nginx 对下面三类请求直接返回 444(什么都不回,直接断开):
1. 路径里任何一段以点开头的请求,比如 /.env、/.git/config、/backend/.env;但 /.well-known/ 必须放行,证书续期要用;
2. 以 .php、.asp、.aspx、.jsp、.cgi 结尾的请求;
3. User-Agent 里带有 libredtail、zgrab、masscan、sqlmap 这些扫描器名字的请求(不区分大小写)。

请写出可以直接放进 443 那个 server 块里的配置,每段配置加上注释,再告诉我怎么检查配置、怎么验证已经生效。
代码:
	# 拦截隐藏文件和目录,.well-known 除外
	if ($uri ~ "/\.(?!well-known(?:/|$))") {
	    return 444;
	}

	# 拦截不存在的动态脚本类型
	if ($uri ~* "\.(php|asp|aspx|jsp|cgi)$") {
	    return 444;
	}

	# 拦截自报家门的扫描器
	if ($http_user_agent ~* "(libredtail|zgrab|masscan|sqlmap)") {
	    return 444;
	}
几个要点:
- 这三个 if 语句放在 server 块里面,而不是放在 server 块里的某一个 location 里面;
.well-known一定要放行。7.3 说过,Let’s Encrypt 续期时要从网站上取一样东西,那样东西就放在/.well-known/acme-challenge/底下。如果把它也拦了,证书到期就续不上了;- 按 UA 拦,只能挡住老实的扫描器,比如日志里见过的
libredtail。但不老实的扫描器伪装 UA 的话我们拦不住。
读到这里,可能会冒出两个疑问。
- 扫描器请求的这些东西我们本来就没有,扫描器原本也只能拿到 404,现在给它们返回一个 444,这样的拦截算哪门子"防护"?
- 通过 444 挂断,对我们有什么好处吗?对攻击者会造成惩罚吗?
这是两个很好的问题,我们先说第一个。
确实,即使不返回 444,这些请求对我们也没有实际的危害,因为我们没有扫描器请求的这些文件。但是今天没有,那下个月呢?明年呢?网站会不会升级,会不会迭代?
万一哪天手滑了,Nginx 的 root 写错了,指到了项目根目录 ~/zero-to-tech(那里既有 .git,也有 backend/.env)。如果这件事情发生了,那么密码和整个代码仓库就被人原样取走。
有了"以点开头的一律挂断"这个配置,就算手滑了,它也送不出去。这就叫纵深防御:每一层都不指望身后那一层一定不出错。
再说第二个问题,通过 444 挂断,会惩罚攻击者吗?
不会惩罚。 444 不是反击,只是不搭理,扫描器会收到一个“空回复”,但是 444 和 404 毕竟还是不一样,对于恶意嗅探,更建议用 444:
- 什么都不透露:404 好歹还有个页面、有响应头,页面底下甚至写着 Nginx 的版本号;444 则一个字都不给。注意,是一个字都不给,连"444"这个数字都不给;扫描器那头收到的,只是一个没有任何回复、被掐断的连接;
- 省一点资源:不用生成、发送响应,能省下一点点服务资源。这一点资源对于单个请求微不足道,但当扫描成千上万次地来的时候就会显著了;
- 日志里一眼认出来:以后看到
444,就知道是"被我们的规则拦下的已知坏请求",和真正的 404 分得开,排查问题时可以省事不少。
再顺手做一件小事:少做自我介绍。
HTTP 的响应头里有一个 Server 字段,Nginx 默认会报告自己的名字和版本号(比如 Server: nginx/1.24.0 (Ubuntu))。这是一件小事,但扫描器拿到版本号,就能去查这个版本有什么已知漏洞,万一哪天这个版本真的被报告了漏洞呢?
其实我们可以要求 Nginx 不要报告自己的版本号。
打开 /etc/nginx/nginx.conf,http 块里有一行被注释掉的 # server_tokens off;,把前面的 # 去掉,reload 之后就只报 Server: nginx 了。
这么做虽然挡不住高手,但我们也没必要主动给人递线索。
改完检查、生效,再从外面试一下:
sudo nginx -t && sudo systemctl reload nginx
curl -I https://example.com/.env      # 本地执行
# curl: (52) Empty reply from server  ← 一个字都没回,连接直接断了
curl -I https://example.com/          # 再看一眼正常页面的响应头
# Server: nginx                       ← 只剩名字,版本号没了
回到访客日志里,/.env 这类请求的状态码变成了 444。
再顺手彩排一次证书续期,确认 .well-known 那条放行没写错:
sudo certbot renew --dry-run
这些规则只挡得住低级的扫描。它们是一层筛子,不是安全的全部。真正的安全,靠的是一层一层的习惯——各种角度的纵深防御。
最后两句
- 后端别用 root 跑。 之前给 systemd 写 service 文件时,写了一行
User=ubuntu。它的意思是:万一哪天代码里有个洞被人捅开,对方拿到的也只是一个普通用户的权限,而不是整台机器。够用就好,不多给一分。 - 及时更新。 公共组件或者开源工具的漏洞在暴露之后,官方一般很快会推出补丁或者更新版本。所以记得
sudo apt update && sudo apt upgrade定期跑一跑,项目依赖有安全公告时及时升级。
优化
敌人来了有猎枪,朋友来了有好酒。对于真正的访客,我们需要优化他们的体验。
前面在分析哪些路径被请求最多的时候,可以看到用户每打开一个页面,背后都跟着一串 JS、CSS 文件,每次都要传一遍,传输的字节数也挺大。
那么我们可以做两件事来优化,一件事是压缩,一件事是缓存。
这两件事都可以在 Nginx 里面做。
第一招:gzip 压缩
先看现状。F12 打开 Network,刷新自己的网站,找到最大的那几个 JS 文件(_next/static/chunks/ 底下,比如演示站的 4bd1b696-c023c6e3521b1417.js),看 Size 列——这是实际从网络上传输的体积。
Nginx 有个现成的能力:把文本类的响应压缩后再传,浏览器收到自己解压。Ubuntu 的 Nginx 其实默认就开着 gzip,但只压 HTML,CSS 和 JS 都没压。在网站配置的 443 server 块里加上:
    gzip on;                       # 开启压缩
    gzip_types text/css text/javascript application/javascript application/json image/svg+xml;
    gzip_min_length 1024;          # 太小的文件不值得压,跳过
gzip_types匹配的是响应头里的Content-Type(5.3 认识过它:这份内容是什么类型)。而.js该报成什么类型,业界正在换口径:一直以来报的是application/javascript,2022 年的新标准改推text/javascript,我们两个都写上,新旧通吃。
sudo nginx -t && sudo systemctl reload nginx
回到 F12,强制刷新,再看 JS 文件,以演示站举例子:
| 文件 | 开 gzip 前 | 开 gzip 后 |
|---|---|---|
4bd1b696-….js | 169 KB | 约 63 KB |
255-….js | 170 KB | 约 54 KB |
同一个文件,传输体积掉了六成多。 这是因为代码和 HTML 都是重复度很高的文本,压缩率天然高;服务器多花一点 CPU,访客少等一大截下载——这笔交换几乎是白赚的。响应头里也能看到凭证:Content-Encoding: gzip。没有这一行,就是没压上。
第二招:静态资源长缓存
第二个问题:访客第二次来,这些文件还要重新下载一遍吗?
可以不用——文件又没变。可以让 Nginx 在响应头里告诉浏览器"这个文件你存着,一年内别再来问了"。同样加在 443 server 块里:
    location /_next/static/ {
        expires 1y;                # 这个目录下的文件,让浏览器缓存一年
    }
reload 之后用 curl 看一眼响应头:
Cache-Control: max-age=31536000 ← 31536000 秒 = 一年
等等——缓存一年? 万一明天就改代码发新版呢?访客的浏览器里存着旧文件,不就一年都看不到新版了?
这时候,4.2 埋下的一颗种子发芽了。看一眼这些文件的名字:
4bd1b696-c023c6e3521b1417.js
255-eb4aecc3ff015961.js
文件名里带着一串指纹(hash),4.2 讲构建时说过:这串指纹是根据文件内容算出来的,内容一变,名字就变。所以发新版之后,页面引用的是一个新名字的文件,浏览器自然会去下载它;而旧名字的文件,本来就永远不会再更新。敢让浏览器"记死",是因为构建工具保证了"变了就改名"——当年那串看起来碍眼的乱码,就是为今天准备的。
F12 验证:刷新第二次,_next/static/ 下的文件一排 (from disk cache)——传输体积 0,本地直接读。回到访客日志里,这些文件的请求也少了:浏览器根本没来要。
如果没看到 (from disk cache),先别急着怀疑配置,检查两处:Network 面板顶部的 Disable cache 有没有勾上,以及刚才是不是用了强制刷新。这两种情况下浏览器都会跳过缓存、重新下载,所以看缓存效果要用普通刷新。Disable cache 只在 F12 打开时生效,不影响普通访客。
Nginx 还有不少这类"门口就能办了"的本事,比如限流(
limit_req,同一 IP 请求太猛就限速)——认个脸,知道它能干这事即可。
统计
最后一个问题:到底来了多少人?
对一个网页产品来说,流量是最关键的指标之一:有多少人来过?看了多少个页面?从哪儿来的——搜索引擎、朋友分享,还是直接敲的网址?在页面上停留了多久?又是在哪一页离开的?
这些问题,理论上都能从访客日志里分析。可前面已经尝过滋味了,很费劲:
- 先得剔除机器人:爬虫、扫描器,还有那些换着 UA 冒充浏览器的;
- 再得剔除无效的请求:404、444、乱码……
- 还得剔除 CSS、JS、图片这些附带的请求:真人打开一页,日志里记下的是一串;
……每一步,都得自己动手。
Linux 上有一些专门的日志分析工具,可以专门基于 Nginx 日志的格式做分析,比较有名的是 GoAccess。它的原理一点都不神秘,就是把前面我们手工干的活给自动化。它认"一个访客"的办法,也和我们手算时一样:同一天里,IP 和 UA 都相同的,算一个人。它可以从 UA 里认出浏览器、操作系统,也能认出一批自报家门的爬虫,甚至能把这些数一遍、排个序,做成一份报告:访客数、热门页面、来源、浏览器、状态码……可以在终端里直接看,也可以生成一个网页,甚至一边读日志一边实时刷新。
我们这一节不详细展开介绍 GoAccess,感兴趣的话可以自己去探索,Ubuntu 上
sudo apt install goaccess即可安装。
但它的短板,也正是日志的短板:
- 机器还混在里面:它能按名单认出自报家门的爬虫,可那些换着 UA 冒充浏览器的,照样被当成人;
- “人"还是靠猜:IP + UA,这种方式算出来的人数必然不准;
- 只看得到"请求了什么”:页面送出去之后,访客在上面停了多久、从哪一页离开——这些发生在浏览器里的事,服务器根本不知道。
想知道更准确的统计数字,以及页面加载到浏览器之后发生了什么,办法只有一个:借助浏览器来统计。 这就是另一类工具——埋点统计。
埋点统计:托管的和开源的
埋点统计的工具也不少,大致分两类:
| 类别 | 例子 | 特点 |
|---|---|---|
| 托管的 | GA、百度统计 | 注册即用,大多免费,维度丰富;数据存在服务商那里 |
| 开源的 | umami、Plausible、Matomo | 可以部署在自己的服务器上,数据留在自己手里(也都提供付费的托管版) |
两类的分别,主要在两处:
- 数据放在谁家。托管的,数据存在服务商那里,省心,但不在自己手上;开源的,可以部署在自己的服务器上。
- 靠什么认人。GA、百度统计靠 cookie 认人;umami、Plausible 则不依赖 cookie。
不管哪一类,基本原理都类似。
埋点:没有魔法
动手之前,先弄懂原理。思考一个问题:
统计服务是统计服务商的(比如 GA 属于 Google),跑在它们自己的服务器上;而访客访问的是我们的服务器。统计服务商如何知道有没有人访问过我们?
我们的服务器不会给它报信。统计服务商需要通过访客的浏览器来上报数据。
办法是:在我们的页面里放一小段 JS。 当页面送到访客的浏览器里,这段 JS 就在那儿跑起来,给统计服务商发一个请求回去:“有人打开了某某网站的某一页”。这就是"埋点"——埋在页面里的一个报信点。
以 GA 为例,一次访问的全过程是这样的:
- 浏览器向我们的服务器要页面——Nginx 日志记下一行;
- 页面里有那段统计代码,浏览器照着去 Google 的服务器,把统计脚本下下来;
- 统计脚本在浏览器里跑起来,第一件事是认人:看看我们的域名底下,有没有一张叫
_ga的 cookie。没有,说明是新来的,就现编一个随机编号,用 JS 写一张_ga存起来;有,就把里面的编号读出来; - 统计脚本向 Google 的服务器发一个请求,上报这些信息:哪个网站(我们的 ID)、哪个人(刚才那个编号)、哪一页、从哪儿来……访客的 IP 和 UA,随着请求自然就带过去了;
- Google 把全世界网站报来的数据汇总、去重、算出各种维度,最后给我们一块仪表盘。
这就是埋点的机制,里面提到的这些技术我们都不陌生。所谓行业黑话,拆开全是熟面孔。
只有第 3 步那张 cookie,和我们之前写 session_id 的 cookie 的机制不太一样。等接上 GA,我们亲眼看看它。
Google Analytics
在许多埋点工具里,名气最大、用得最多的,就是 Google 家的 Google Analytics,简称 GA(现在的版本叫 GA4),群众基础很广泛。李勃老师的课件网站 李勃老师.com,也用了它。
所以,我们就给自己部署的 zero-to-tech 也接上 GA。
GA 是 Google 的服务,注册账号、打开后台,都需要我们(作为开发者身份)能访问 Google。
你现在可能担心的是另一个问题:我们作为开发者可以访问 Google(办法总比困难多),但是 GA 的埋点脚本如果放在页面上发给浏览器,那么用户是不是也需要能够访问 Google 才可以上传数据呢?我们总不能要求用户来克服网络问题吧?
这个担忧是有道理的,但是好在埋点脚本在上传数据的时候使用的域名并非 www.google.com,而是 www.google-analytics.com,另外还会用到一个域名是 www.googletagmanager.com,用来下载统计脚本——目前在中国大陆访问这两个域名是不需要魔法的。
其实你也完全可以尝试用别的埋点工具,比如说 umami,但如果只讲一种,那我倾向于介绍 GA 的用法,毕竟它的用户基数最大。
给网站植入 GA
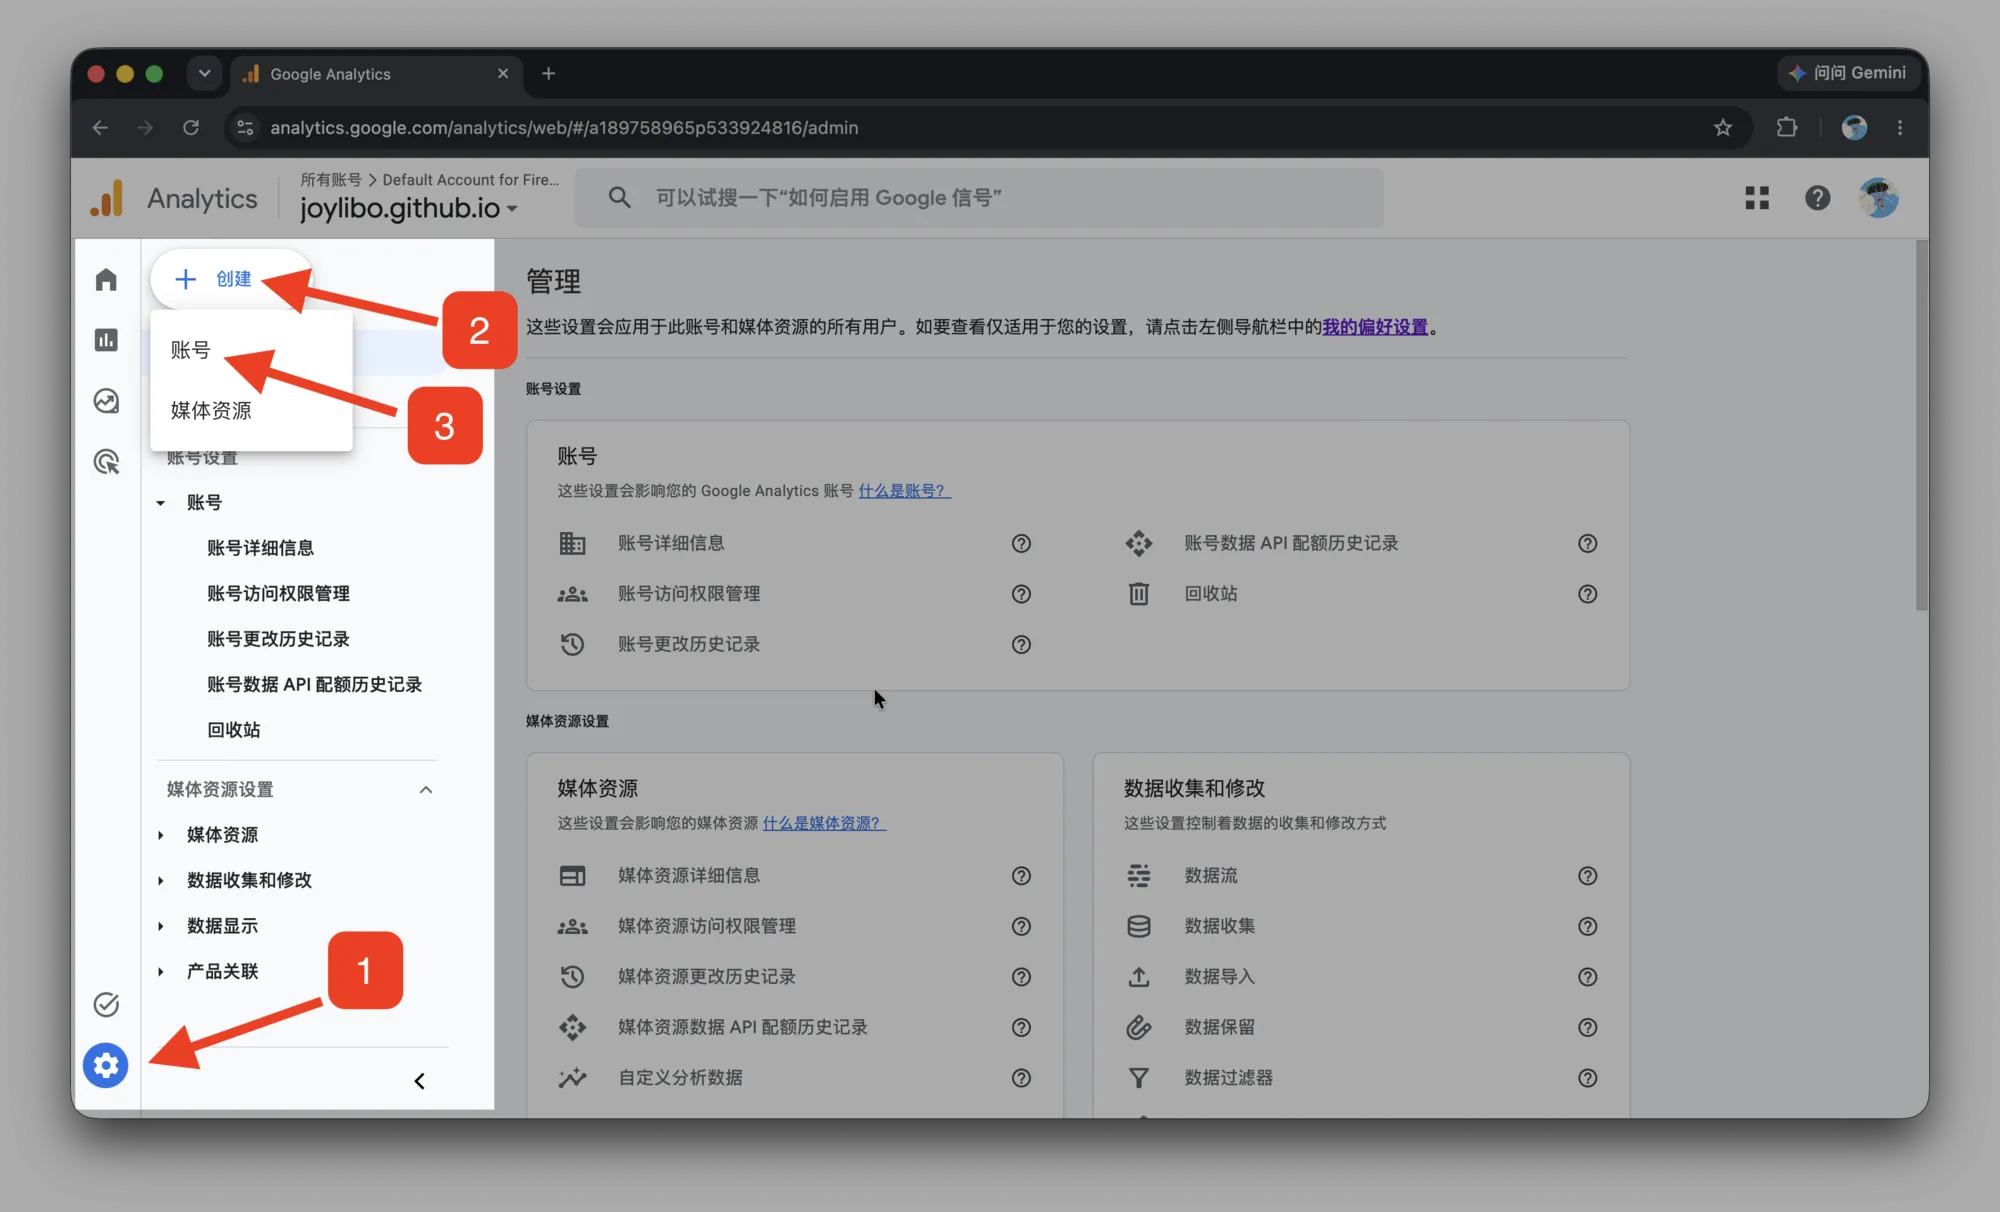
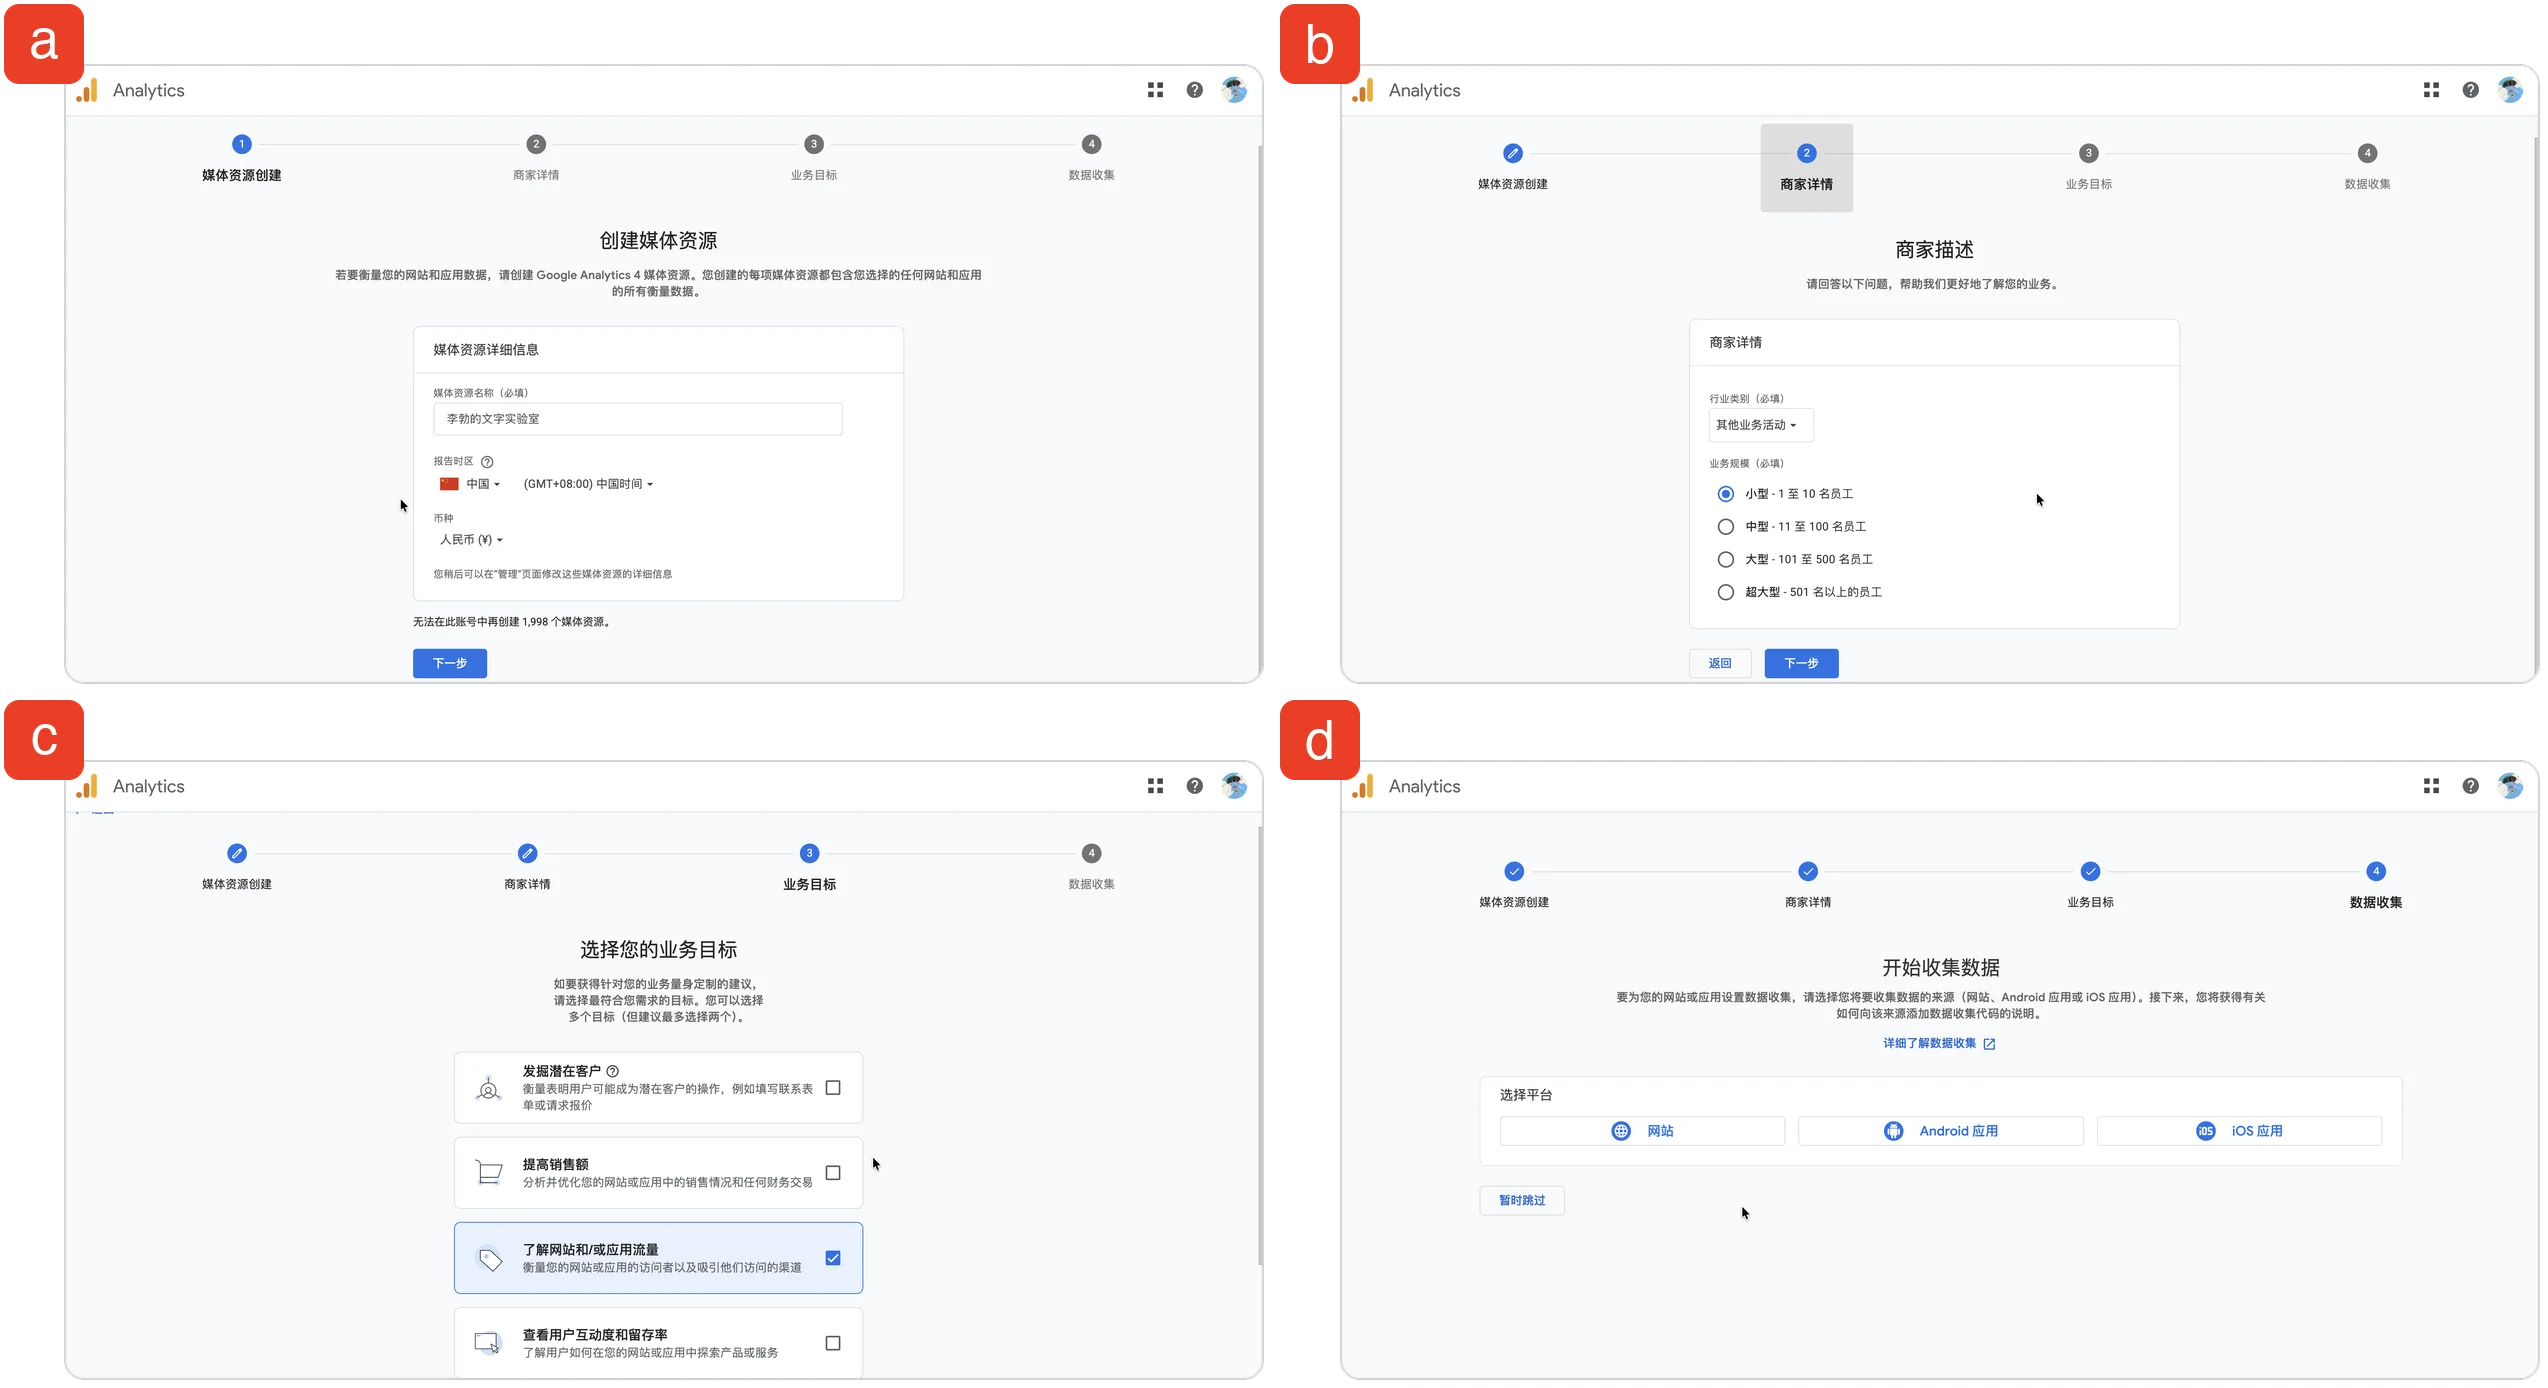
第一步,注册拿 ID:用 Google 账号登录 analytics.google.com,跟着引导依次建一个账号(如果你已经有账号的话,可以直接跳过这一步,开始创建媒体资源)、一个媒体资源(时区选"中国"),平台选网站,填上我们的域名,建好一个数据流。最后拿到一串衡量 ID,G- 开头,长得像 G-ABC123XYZ9。(后台界面时常改版,以实际看到的为准,记住"媒体资源"“数据流"“衡量 ID"这几个名字就够了)
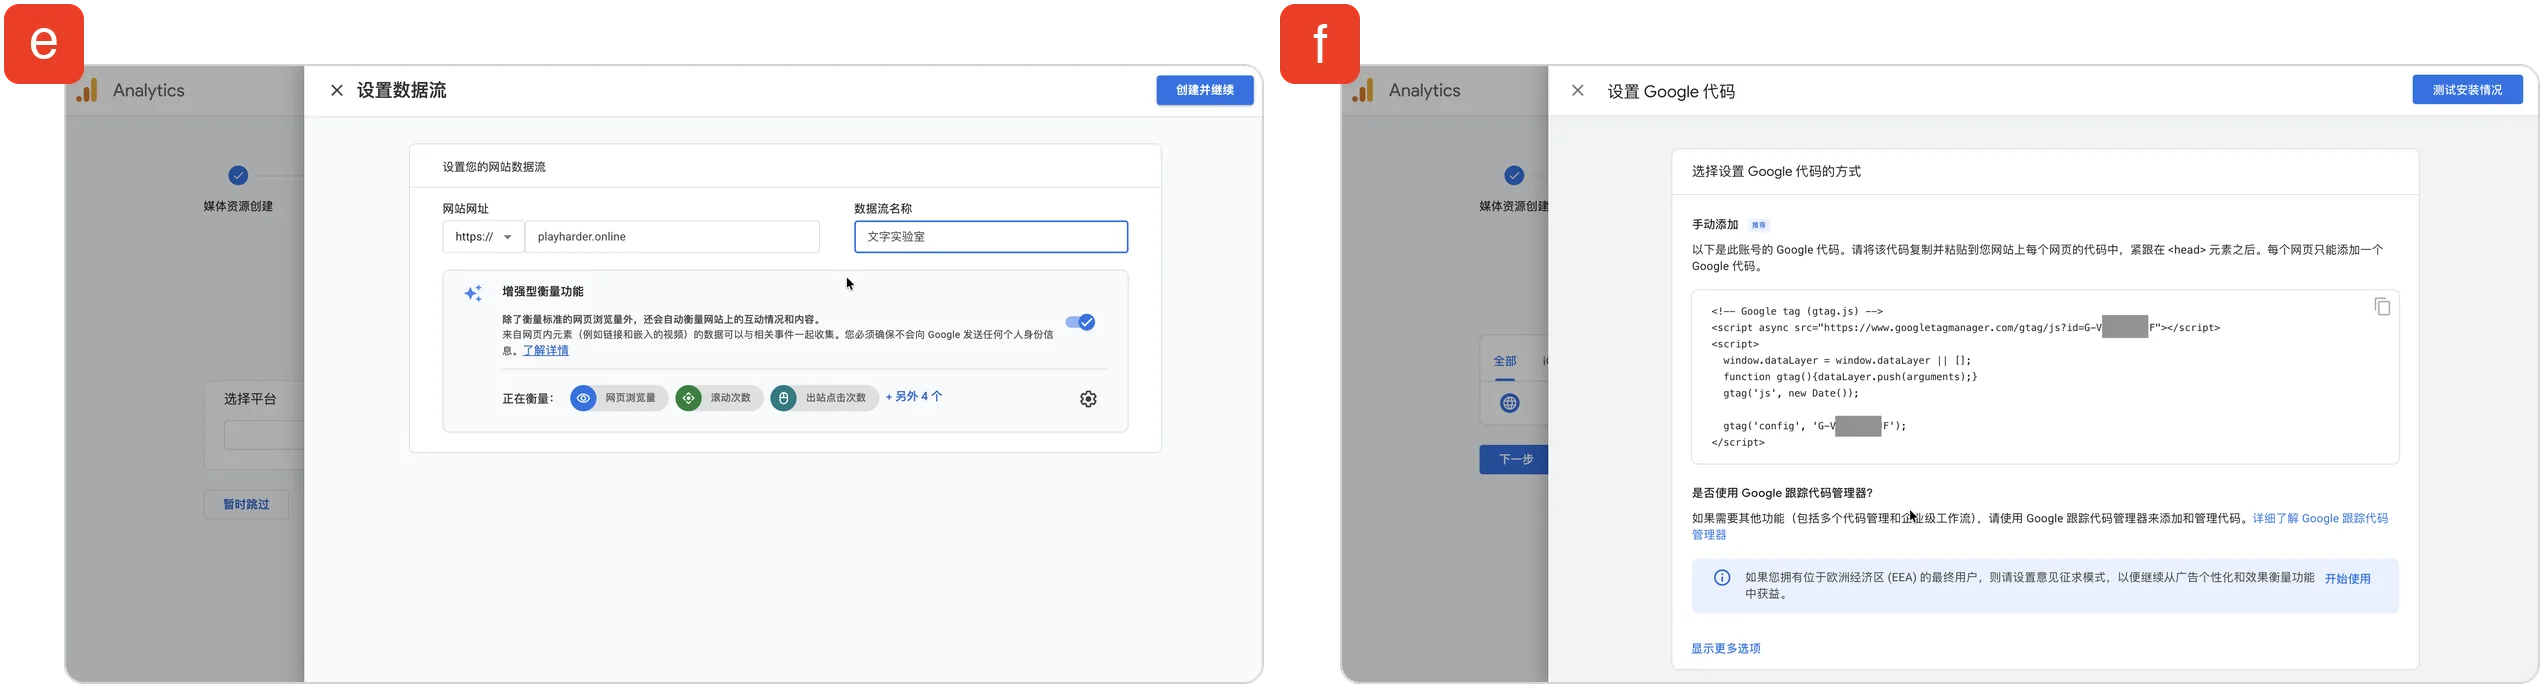
第二步,先看清它给了什么。GA 给的跟踪代码长这样:
<!-- Google tag (gtag.js) -->
<script async src="https://www.googletagmanager.com/gtag/js?id=G-XXXXXXXXXX">
</script>
<script>
	window.dataLayer = window.dataLayer || [];
	function gtag(){dataLayer.push(arguments);}
	gtag('js', new Date());

	gtag('config', 'G-XXXXXXXXXX');
</script>
这段脚本其实就做了两件事:
- 第一个
<script>:从 Google 的服务器上,把统计脚本gtag.js下下来。地址末尾带着我们的衡量 ID。 - 第二个
<script>:在页面里备一张"待办清单”(dataLayer),并且标记一下网站 ID。统计脚本一到,就照着清单把"现在打开了哪一页"报回 Google。
这就对应了刚才介绍的埋点机制,一个脚本地址和一个 ID,ID 负责告诉统计服务商这是谁家的网站。
第三步,植入。 Google 给的脚本是原生 JavaScript 脚本,可以直接插入到 html 中,但是我们现在的前端已经是一个 React + Next.js 工程了,所以要换一种植入方式。
你可以让 AI 帮你做,如果你使用的是本地的 AI Agent 宿主工具,prompt 如下(需要先把当前项目路径授权给 AI 工具):
在当前项目中植入GA脚本,当前项目的前端是一个 React + Next.js 工程,需要确保全站所有页面都可以加载到这份脚本,脚本如下:

<!-- Google tag (gtag.js) -->
<script async src="https://www.googletagmanager.com/gtag/js?id=G-XXXXXXXXXX">
</script>
<script>
	window.dataLayer = window.dataLayer || [];
	function gtag(){dataLayer.push(arguments);}
	gtag('js', new Date());

	gtag('config', 'G-XXXXXXXXXX');
</script>
如果你使用的是会话式聊天 AI,无法直接操作你的计算机,prompt 如下:
我当前有一个基于 React + Next.js 工程的项目,其 app 目录结构如下:
app
├── layout.jsx
├── page.jsx
└── text-lab
    └── page.jsx

需要确保全站所有页面都可以加载到这份脚本,脚本如下:

<!-- Google tag (gtag.js) -->
<script async src="https://www.googletagmanager.com/gtag/js?id=G-XXXXXXXXXX">
</script>
<script>
	window.dataLayer = window.dataLayer || [];
	function gtag(){dataLayer.push(arguments);}
	gtag('js', new Date());

	gtag('config', 'G-XXXXXXXXXX');
</script>

告诉我接下来如何操作,并给我具体的需要插入的脚本和插入方式。
AI 会帮你做(或者指导你做)两件事:
- 在
app/layout.jsx文件顶部引入next/script,这是 Next 内置的"往页面里放第三方脚本"的组件。
import Script from "next/script";
- 在
app/layout.jsx文件的<body></body>区域内写入两段<Script>标签(注意 S 是大写,不是原生的<script>标签)
        <Script
          src="https://www.googletagmanager.com/gtag/js?id=G-XXXXXXXXXX"
          strategy="afterInteractive"
        />
        <Script id="ga-init" strategy="afterInteractive">{`
          window.dataLayer = window.dataLayer || [];
          function gtag(){dataLayer.push(arguments);}
          gtag('js', new Date());
          gtag('config', 'G-XXXXXXXXXX');
        `}</Script>
之所以写入到 app/layout.jsx 文件中,是因为 Next 全站每一页都套在这个 layout.jsx 的壳里,把脚本放这儿,等于全站每页都有。
Next 官方还提供了一个封装好的组件,一行就能接 GA,所以如果是本地的 AI Agent 宿主工具,也有可能会使用它。区别是它这种方式不直接使用
next/script,而是使用@next/third-parties/google。两种方式都可以。
第四步,推送代码,发布上线:
# 本地
git add -A && git commit -m "接入 GA 统计" && git push
# 服务器
cd ~/zero-to-tech && git pull && npm run build
前端是 Nginx 直接从 out/ 里送出去的,重新 build 完就生效,Nginx 和后端都不用动。
见证仪表盘上第一个访客
打开 GA 后台,进报告 → 实时,然后用电脑的浏览器或者手机访问自己的网站,几秒到十几秒之后就可以在仪表盘的 过去 30 分钟的用户 这一栏里看到我们的访问痕迹了。
实时报告几秒就有,但其他常规报告要等一天才能汇总出来。
过两天可以再来对一下账,你会发现同一段时间里日志里有几百个不同的 IP,但 GA 报的用户会少得多。两者的差异主要是机器人和扫描器,因为机器人和扫描器一般只会拿 HTML,不会跑 JS 脚本,也就不会上报给 GA 了。
GA 写的 Cookie
刚才讲 GA 埋点的原理的时候,说过它会在浏览器中放一个 Cookie,此时我们可以在浏览器中看到它了:F12 → Application → Cookies,看看我们自己的域名底下多了什么。
除了之前后端写入的那个 session_id,此时应该也多了 _ga 和 _ga_XXXXXXXXXX 两个新的名字。
我们之前(6.6 那一节)学的 cookie 是服务器用 Set-Cookie 发给浏览器的,浏览器存着,下次请求时自动带回服务器,而且 JS 都读不到 cookie 的内容。那么这次这两个新的名字是怎么回事?
这是因为 cookie 有两种写法:
- 一种是服务器在响应头通过
Set-Cookie写到浏览器,我们此前写 session_id 就是这种方式,这种后端写进去的 cookie 可以声明不给前端 JS 脚本读,只需要带上HttpOnly属性即可; - 一种是页面里的 JS 直接往浏览器里写,它自己也可以读。今天看到的这两个新的 cookie 就是 GA 的埋点脚本自己写的,此时它只是把浏览器的 cookie 当成了一个存储,这些是它在用户的浏览器里放的记号,以后上报的时候再从这里取。
放在一起比一比
session_id(6.6) | _ga | |
|---|---|---|
| 谁写的 | 我们的后端,用响应头 Set-Cookie 发下来 | GA 的脚本,在浏览器里用 JS 写 |
| 记在谁的名下 | 我们的域名 | 也是我们的域名 |
| JS 读得到吗 | 读不到(HttpOnly) | 读得到——本来就靠 JS 读 |
| 交给谁用 | 浏览器自动带回我们的服务器 | 统计脚本读出编号,抄进发给 Google 的请求 |
| 管多久 | Max-Age 写的 30 天 | 默认 2 年(浏览器未必让它活这么久,比如 Safari 最多给 JS 写的 cookie 留 7 天) |
埋点脚本也并非一定会用 cookie,比如说我们前面介绍埋点工具时候列出来的那个 umami 用的就是另一种技术——它不用 cookie 来标记用户,而是在每次上报时把网站、访客 IP、浏览器 UA 等放在一起计算出来一个值,用这个值来标记一个用户。这种方式理论上没有 GA 这种留 cookie 的方式认得那么准,但是考虑到现在很多国家对 cookie 技术的使用约束越来越严格,这种不用 cookie 的做法也越来越受欢迎。毕竟埋点统计只想知道“大概多少人”而已。
统计会漏,也要有边界
统计一定会漏。 有一批访客装着广告拦截插件,GA 这类统计脚本往往就在拦截名单上;也有访客的网络加载不到统计脚本。这些情况下,统计服务上就采集不到用户的访问数据了。
收集也要有边界。 边界感是:看聚合,不追个人——我们关心"今天有 50 个访客”,而不是"这个 IP 是谁"。很多国家和地区对此有专门的法律,国内是《个人信息保护法》,认真做产品的人迟早要正面学它。逛国外网站时常见的那个"是否接受 cookie"的弹窗,就是这类法律的产物:用 cookie 做统计,在有些地方得先征得访客同意。
但还有一类 cookie 不一样:广告商的脚本装在成千上万个网站上,用的是记在它自己域名下的“纸条”——同一张纸条,在甲网站认出你,在乙网站也认出你,“你逛过哪些地方"于是被串成了一条线。行业里管这叫第三方 cookie(我们不学这些,认个脸即可),各家浏览器这几年一直在收紧它。
两种看访客信息的视角对比
| Nginx 访客日志 | 埋点统计 | |
|---|---|---|
| 立场 | 服务端记账:到达服务器的每个请求 | 浏览器上报:访客页面里的 JS 发回的数据 |
| 内容 | 原始、全量——含爬虫、扫描器、API 调用 | 加工过的维度——访客数、地域、设备、停留时长 |
| 短板 | 要自己读、自己算;记录≠人 | 依赖 JS 加载,可能会被拦截,统计不全 |
| 什么时候看 | 排查问题:“请求到底到没到?状态码多少?” | 了解用户:“多少人?从哪来?看什么?” |
一句话记住这两种视角:日志是真相,统计是视图。
收尾
网站看得见访客了,门也守严了,速度也提上来了。访客越来越多,他们留下的历史记录也越来越多,目前全都存在那个小小的 SQLite 文件里。
下一节,我们把存储从 SQLite 换成 PostgreSQL,带着真实的访客数据,走一次数据迁移。